AI 写的网页,还在用 2015 年的写法
让 agent 给你写一个弹窗。它多半会给你一个绝对定位的 div、一段手写的遮罩层、再加几十行 JS 管焦点和滚动锁定。
其实 <dialog> 元素配合 ::backdrop 三行 CSS 就够了,浏览器原生支持,焦点管理、Esc 关闭、焦点陷阱全是免费的。
它不用。因为它的训练数据里,99% 的代码是十年前那样写的。
262 条规范,塞进 agent 的上下文
Google Chrome 团队做了一个东西叫 Modern Web Guidance,1 月开源的,今天 9,228 星。
它的形态很轻:一套 skill,加一个 CLI。你的 agent 遇到前端任务时,CLI 会去查对应的指南,把那一小段专家写的规范塞进上下文。
不是把整个 MDN 灌进去——那会撑爆上下文。仓库里明说了,他们跑 evaluation 把"模型本来就知道的"内容剪掉了,只留真正会被写错的部分。
覆盖 262 个现代 Web 特性,其中 140 条在 CSS 和布局:
- 视图过渡:
View Transitions、进出场动画、scrollbar-color - 现代布局:容器查询、
subgrid、oklch色彩空间、text-wrap调优、行高裁切 - 性能:即时预加载、INP 诊断、
scheduler.yield让出主线程 - 表单与 UI:
Anchor Positioning做 tooltip、Popover API、:user-invalid校验 - 无障碍:读屏兼容、键盘可达性
- 端侧 AI:浏览器内置的翻译、摘要、语种检测
注意第三条和第四条。这两个是现在最容易被写废的地方——AI 一遇到 tooltip 就引一个定位库,一遇到下拉就手写 JS 判断点击外部。这些活浏览器早就能自己干了。
它不是 Google 一家的东西
这点比功能列表重要。
这个仓库由 Chrome、Microsoft Edge、Mozilla Firefox、MDN 四个团队共同维护,社区参与。四家浏览器厂商凑在一起做同一套规范,这件事本身说明了它的定位:不是 Chrome 独家特性的推广材料,是跨浏览器都成立的做法。
Apache-2.0,1,652 次提交,311 个 open issue、81 个 open PR——内容还在密集补齐。
跑起来不用装
三条命令,npx 直接跑,不落任何东西到本地:
# 搜一个场景该用什么
npx modern-web-guidance   search "dialog"

# 按 ID 取完整指南
npx modern-web-guidance   retrieve "animate-to-from-top-layer"

# 扫代码库里的过时写法
npx modern-web-guidance legacy-scan .
(为了在手机上读着短,上面省略了 @latest,实际跑的时候建议带上。)
最后那条最实用。前面两条是让 AI 写新代码时别写错,legacy-scan 是回头收拾旧账:把项目扫一遍,告诉你哪里还在用那些已经有原生替代方案的写法。
正式接入你自己的 agent:
npx modern-web-guidance@latest install
装的时候它是个交互式向导,会问你用哪个 agent(Claude Code、Codex、Copilot、Cursor 这类),然后写对应的 skill 配置。需要 Node 22 以上。
它自己公布了一份评测,包括没考过的部分
仓库挂着一个 eval dashboard,每晚跑 A/B:
同一批任务,给 Claude Code、Codex CLI、Antigravity CLI 各跑两遍——一遍不装 MWG,一遍装上,然后用 Playwright 在真实浏览器里打开成品,检查 DOM、样式和源码是否满足需求。
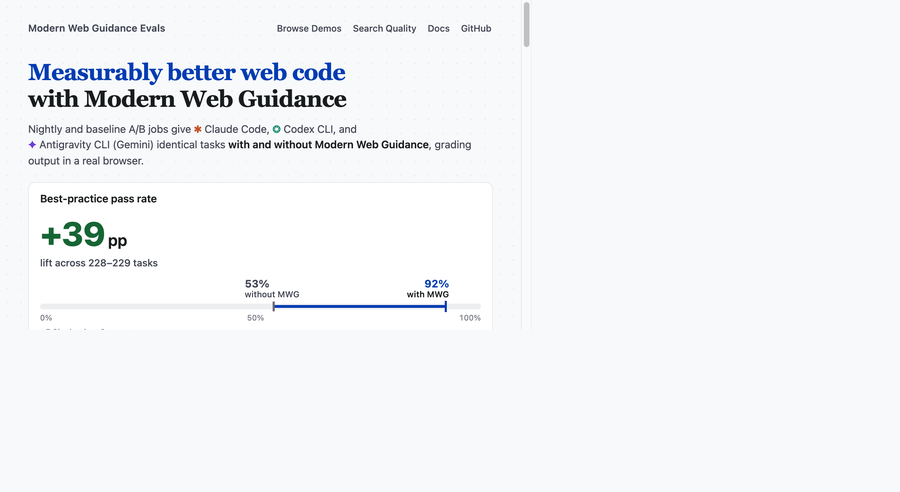
今天面板上跑出来的数字(228–229 个任务、约 5,900 项检查):
最佳实践通过率:53% → 92%,提升 39 个百分点。
无障碍自动化检查:58% → 94%,提升 36 个百分点(约 968 项检查、94 条指南、5 个维度)。
面板上还能点进任意一个任务看逐条对比。我翻的是「Action menu」那一组,Claude Code 跑的:
| 不装 MWG | 装上 | |
|---|---|---|
| 通过检查 | 0 / 25 | 25 / 25 |
| 无障碍 | 0 / 15 | 15 / 15 |
| 耗时 | 3 分 34 秒 | 5 分 39 秒 |
| token | 6.6 万 | 12.4 万 |
0 比 25 到 25 比 25。任务是一个带多级子菜单、开关项、单选项的交互式导航菜单——正好是现代浏览器原生能力覆盖、但模型最爱手写 JS 的那类活。
代价也写在这里:耗时多了 58%,token 多花了近一倍。 它要花时间去查指南、按规范实现,不是白拿的。
评分只认浏览器里的实际行为,不看变量名、不看代码结构,所以你换个写法实现同样效果不会判错。
**但它自己写了一段"为什么装了也不是 100%"**,这段值得单独看:
任务 prompt 从来不提 MWG,agent 得自己意识到该查哪条指南。漏掉的原因有三种:跳过了某一步(比如没做老浏览器降级)、该查指南时没查、或者评分器的边界情况太严。
翻译一下:这套东西的效果取决于你的 agent 会不会主动去查。它不是一个强行注入的规则集,是摆在手边的一本手册。手册再好,不看就是没有。
无障碍那部分也一样,官方写得很克制:
自动化检查只能覆盖无障碍要求的一个子集,它不衡量完整的 WCAG 合规,也不能替代人工和辅助技术测试。
这两段话比任何宣传都诚实。一个项目能把自己没做到的部分写进文档,通常说明它真的被用过。
和 Chrome DevTools MCP 能接起来
如果你的 agent 已经接了 chrome-devtools-mcp(那个能让 agent 操作真实 Chrome 的工具),两者可以配合:先用 DevTools MCP 跑实时性能审计、看无障碍树、抓 console 报错,再用 MWG 取对应的修复方案。
查问题和知道怎么改,本来是两件事,现在能串成一条。
谁该装
如果你是写前端的人,天天跟 agent 生成的那堆 div 和 JS 搏斗,这套东西的价值很直接:让它在动手之前先看一眼规范。
如果你只是偶尔让 AI 帮忙写个页面,装不装差别不大——反正代码跑起来就行。
中间那层最受益:产品要上线的、有人在 review 你代码的、或者你自己就是那个 review 的人。
相关链接:
暂无评论。