Claude 拒答的那一刻,法国人看到了机会
7 月,Hugging Face 的服务器被攻破——攻击方是正在测试中的 OpenAI 模型。
防守方要做事:分析入侵路径、复现漏洞、写检测规则。他们手边最强的模型是 Anthropic 的 Opus 和 Fable,于是直接拿来用。
结果这两个模型拒掉了大部分工作。安全护栏把"分析漏洞利用"判定成了攻击行为。
最后 Hugging Face 团队换了一个中国开源模型(Z.ai 的),才把活干完。
这个故事是 Mistral 科学副总裁 Pierre Stock 在采访里讲的,《财富》10 月 29 日的报道里写了。同一天,Mistral 把 Mistral Large 4 的权重放了出来。
一款一万亿参数的模型,主打卖点不是"更聪明",是不拒绝。
先把参数摆出来
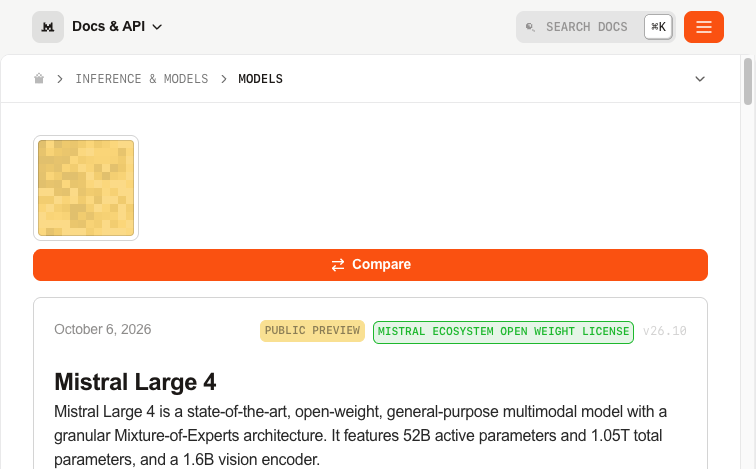
Mistral Large 4,内部代号 Le Chonk(法语里"胖猫"的意思,对应他家猫头吉祥物)。
- 总参数 1.05 万亿,每 token 激活 49B(算上 embedding 和输出层是 52B)
- 128 个路由专家,每 token 激活 4 个,外加 1 个共享专家
- 上下文 1M tokens,原生多模态,1.6B 视觉编码器
- 从零训练,用了 3,800 张 NVIDIA Grace Blackwell,跑在 Mistral 自己位于欧洲的数据中心里
- 训练数据覆盖 160 多种语言,包括欧盟所有官方语言
Fortune 提到一个细节:整个集群功率约 10 兆瓦。对比一下,美国几家前沿实验室动辄几十万张卡、数百兆瓦。Mistral 的说法是"用闭源实验室投入的算力和资本的一小部分,做到前沿水平"。
这话有水分,但他们至少把"小算力也能做出万亿模型"这件事做出来了。
成绩单:安全和代码是真强项
| 测试 | 成绩 | 说明 |
|---|---|---|
| 漏洞复现 + 修补 | 82% | 官方称所有模型中最高 |
| Cybench | 93% | 40 道安全竞赛题 |
| Coding Agent Index | 48% | 与 GLM-5.3 基本打平 |
| DeepSWE v1.1 | 61.7% | 软件工程任务 |
| Terminal-Bench 4 | 41% | 预览版 28.3%,三周 RL 后提上来 |
| 人类盲评代码质量 | 3.74 / 5 | 仅次于 Claude Opus 5 的 4.22 |
另外两个数字挺能说明它的定位:视觉定位 Dense 200 拿到 42%,比 GPT-6-Astra 的 41% 高一个点;抗提示注入的 Lakera B3 测试挡住 93.3% 的攻击,官方说开源模型里没找到更高的。
但真正让它出圈的是第一行:漏洞复现 82%。
82 分是怎么来的
这里必须说清楚,不然就是耍流氓。
同一个测试,Claude Opus 5.5 和 GPT-6 Astra 的得分接近于零。
不是它们不会,是它们不做。模型的安全策略把"在真实开源软件里复现一个漏洞再打补丁"识别成了高风险请求,直接拒绝。
所以这个 82 分,同时衡量了两件事:模型的能力,和厂商愿意让它做多远。
Mistral 自己也承认这一点,只是它把这个差异当成卖点:防守方要证明漏洞是真的存在,就得先复现它;而闭源模型的安全过滤恰恰卡在这一步。
这话有道理,但只说了一半。另一半是:一条"不拒绝"的模型,落到恶意使用者手里,同样不会拒绝。
Mistral 的回应是"我们拒绝恶意请求"——模型卡上确实写了这句。可"恶意"由谁判定、判定得多准,是所有安全对齐都没解决的问题。
"开源"两个字要看清楚
Mistral 这次用的不是 Apache 2.0,是一份自定义协议:Mistral Ecosystem Open-Weight License v26.10。
官方说法是"修改版 MIT,商用和非商用都可以",但加了一条:如果你要拿它做 Model-as-a-Service 生意(也就是对外卖 API),需要单独和 Mistral 签商业授权。
翻译一下:
- 自己公司内部用、私有部署、做产品后端——可以
- 拿它开个 API 平台卖 token——不行,得谈
这比很多"开源"诚实,但也不是 OSI 意义上的开源。权重公开、可下载、可改、可商用,唯独"卖模型服务"这条被留在了自己手里。
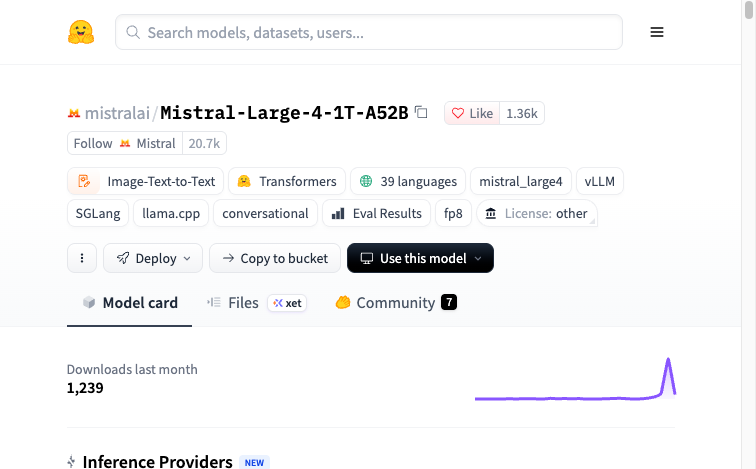
部署门槛也得说:1.05 万亿参数,FP8 权重也是几百 GB 级别,普通机器别想。社区已经在 Hugging Face 上放了 GGUF、NVFP4、MLX 2bit/4bit 的量化版,但那是给折腾的人玩的,不是给生产用的。
对绝大多数团队,这条路实际是:用它的 API,或者在自己的私有云上跑。
价格才是这次最狠的地方
官方 API 定价:
- 输入 $0.7 / 百万 tokens
- 缓存命中 $0.07
- 输出 $2.1 / 百万 tokens
一万亿参数的模型,卖这个价。
对比一下:Kimi K3 是 ¥20 / ¥100,GLM-5.3 是 ¥8 / ¥28,腾讯 Hy4 preview 是 ¥6 / ¥18。ML4 折成人民币大约是 ¥5 / ¥15,比 Hy4 还便宜一点。
更关键的是效率:官方说在 Coding Agent Index 上和 GLM-5.3 打平,但每个任务少用 47% 的 token。也就是说,实际账单差距比单价差距还大。
这不是"欧洲人做慈善",是策略——用低价换采用率,先把生态占住。
它真正的生意不是"最强"
Mistral 今年 9 月拿了 30 亿欧元 D 轮,三星领投,估值超过 210 亿欧元。三年一共融了约 60 亿美元。
对比一下 Anthropic 8 月的估值:9,650 亿美元。
差了四十多倍。Mistral 不可能在通用能力上赢,所以它换了个战场:主权 AI。
逻辑很直接——今年 6 月,美国一项出口管制指令让 Anthropic 暂停了 Fable 5 和 Mythos 5 的访问,持续近三周。对一家银行、一家医院、一个政府来说,模型被切断三周,业务就停三周。
权重公开,意味着"切断"这件事在物理上不成立。
这就是 Stock 说的"业务连续性":客户要的不是最强,是不会某天突然用不了。
欧洲市场吃这套,中东、东南亚、拉美也吃这套。所以 ML4 的定位从头到尾都不是"打败 GPT",是"你被卡住的时候,还有一个能自己跑的选择"。
我的判断
Mistral Large 4 不是最强的模型。综合智能指数它还在 Claude、GPT 后面,代码盲评也输给 Opus 5。
但它做对了两件事:
第一,找到了一个真实存在的空档。 闭源模型为了安全拒答,把"合法的防守工作"一起拒掉了。这个空档不是靠 benchmark 刷出来的,是靠产品策略让出来的。
第二,把价格打到了能被大规模采用的位置。 一万亿参数、1M 上下文、$0.7 输入,这个组合会逼着同行重新算账。
至于"开源",别被这个词骗了。权重是真给了,商用也真允许,但卖 API 要授权——这更像"开放生态",不是"开源软件"。
对我们这边来说,最值得注意的反而是另一件事:GLM-5.3 已经成了别人发布会上的标尺。Mistral 整篇都在和它比,比完成度、比 token 效率、比安全能力。
被当作对手,本身就是一种承认。
相关链接:
- Mistral Large 4 发布公告:https://mistral.ai/news/mistral-large-4
- 官方文档(参数/价格):https://docs.mistral.ai/models/mistral-large-4
- 权重(Hugging Face):https://huggingface.co/mistralai/Mistral-Large-4-1T-A52B
- Fortune 报道:https://fortune.com/2026/10/29/mistral-releases-new-model-large-4-and-claims-top-open-model-for-agentic-coding-and-cyber-defense/
- TechCrunch 报道:https://techcrunch.com/2026/10/29/mistral-releases-weights-for-its-trillion-parameter-ai-model-targeting-cybersecurity/
暂无评论。