史上最强模型,官方劝你先别用
11 月 9 日,Anthropic 发布 Claude Fable 5.2 和 Mythos 5.2。
第三方评测机构 Artificial Analysis 给出 65 分,这是它测过的最高分;Vals AI 把它排在 36 个模型的第一;Anthropic 自己的表里,它赢了 Opus 5.5 十项中的九项。
然后官方文档写了一句很扫兴的话:大多数 coding 和知识工作,建议先从 Opus 5.5 开始。
史上最强,和“最该用”,第一次分得这么开。
三句话看懂
最强:AA 65 分,历史最高。
最贵:max 档 $26.54 一个任务,烧 2.75 亿 token。
官方建议:日常先用 Opus 5.5。
65 分,史上最高
先看硬指标。
| 模型 | 分数 / 单任务成本 / 耗时 |
|---|---|
| Fable 5.2 · max | 65 / $26.54 / 44.1 分钟 |
| Fable 5.2 · high | 62 / $9.08 / — |
| Gemini 4 Carbon | 60 / $7.76 / 28.3 分钟 |
| Opus 5.5 · max | 59 / $10.04 / 25.4 分钟 |
| GPT-6 Astra · max | 57 / $6.24 / — |
价格还降了:输入从 $10 降到 $8,输出从 $50 降到 $40,比 Fable 5.1 便宜 20%。上下文 1M,最大输出 128K,官方说输出速度比 5.1 快 30%。
在 Anthropic 自己的跑分表里,它对 Opus 5.5 的优势很具体:
- FrontierCode 2.0:**49.1%**,Opus 45.5%,GPT-6 Astra 42.8%
- FrontierSWE v2:**69.9%**,Opus 62.3%
- Terminal-Bench-Science:**74.6%**,Opus 58.7%
- OSWorld 2.1:**89.3%**,Opus 87.2%
- Remote Labor Index:**41.3%**,Opus 21.3%
- Humanity's Last Exam:**74.2%**,Opus 67.7%
- RoboDojo 机器人:**64.9%**,Opus 39.4%
对比 Fable 5.1,FrontierCode 从 32.4% 跳到 49.1%,几乎翻倍。
独立的 Vals AI 也给了第一,但优势很窄:71.31%,第二的 Sonnet 5.5 是 70.85%,Gemini 4 Carbon 70.45%。而且它在 SWE-bench Multimodal 上输给 Opus 5.5 八分,法律和税务测试只排到 20/37 和 27/84。
它不是全面碾压,是长任务碾压。
三件不像跑分的事
Anthropic 在发布文里放了几个 demo,比分数更有画面感。
第一,8 天造一个操作系统。 一个工程师让 Fable 5.2 从空文件夹开始写 OS。模型协调了 1,000 多个子代理,连续跑 8 天,写代码、测试、review,最后产出一个能在笔记本上启动的系统:自己的内核、磁盘/键盘/网络驱动、持久化文件存储、窗口、登录界面、安装器,还内置了 Claude 功能。
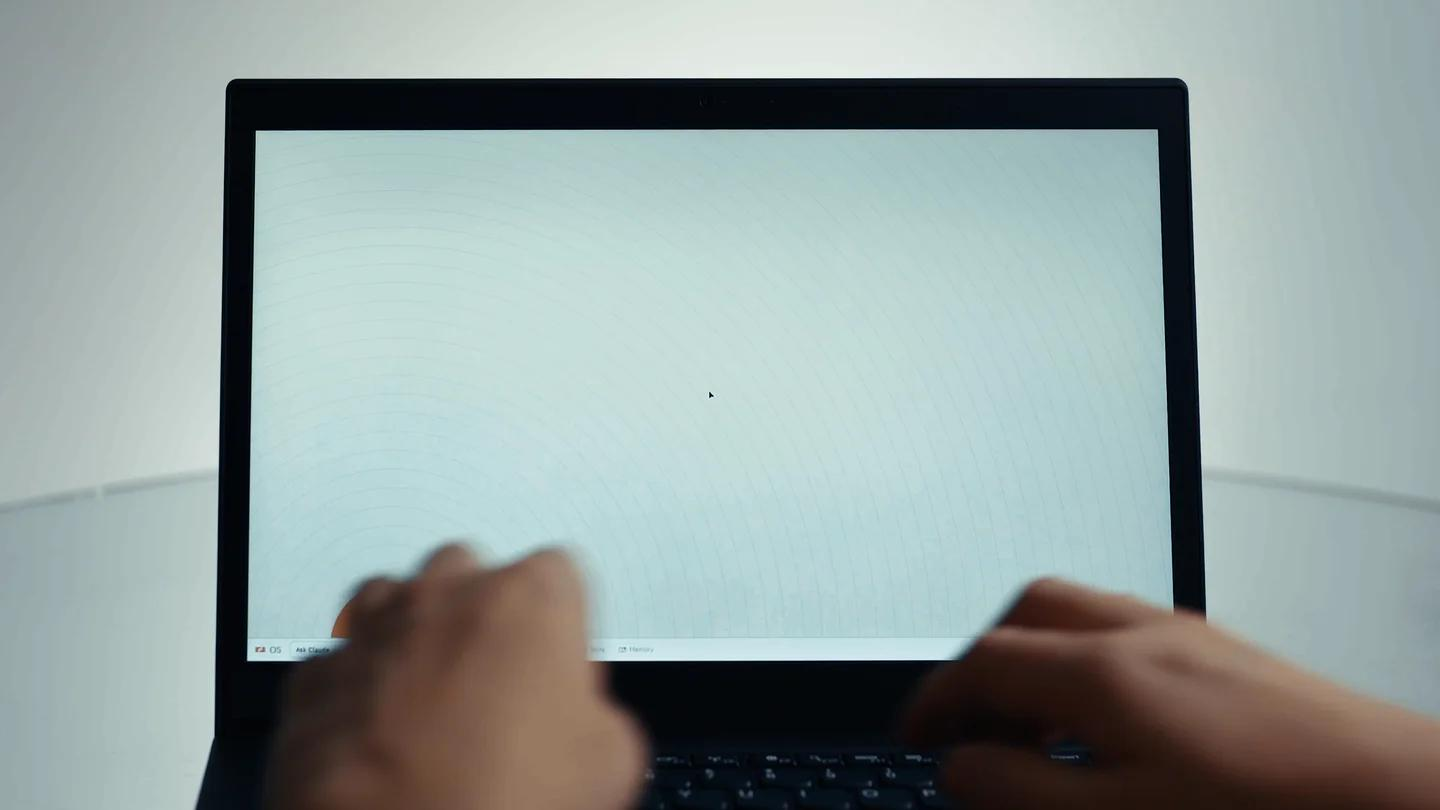
官方演示:从空文件夹构建的 OS 在笔记本上启动
第二,30 小时形式化费马大定理。 1,000 个 Fable 5.2 代理,把已有的费马大定理证明翻译成 Lean 可以逐步检查的形式,用了 30 小时,人工干预很少。Anthropic 说上一代研究模型做同样的事用了 11 天;Opus 5.5 在同样设置下,18 小时只完成 26%,之后基本不动了。
注意:这是形式化已有证明,不是重新证明费马大定理。
第三,两个黑洞问题 + 三个电子设备。 Fable 5.2 完成了 2003 年提出、一直没人算完的一个黑洞相变计算,还找到了一个用了 17 年的量子引力筛选技术的精确上限(9.1266)。另外,它和电路板公司 Diode 合作,从一段话设计出三个能工作的电子设备:语音助手 hub、USB 音箱、手持电子宠物,都没改电路。
官方演示:机械臂在解魔方
还有蛋白质:Mythos 5.2 用一种新方法预测完整衣壳结构,34 个里准确建模 28 个。
但论文没有作者
这是整场发布里最值得停下来看的地方。
两个黑洞结果发了预印本,挂在 Hexagon 上,日期是 11 月 7 日。论文署名是“Claude (Anthropic)”,没有一个人类物理学家署名;Anthropic 的发布文说,是一个“内部的 Claude 研究模型”做的,但没说具体版本——system card 里的定义是“比 Claude Mythos 5.2 稍强一点的未发布模型”。
也就是说:
- 没有同行评审
- 没有具名作者
- 没有说明到底是哪个模型
- 第二个结果,Opus 5.5 后来也独立算出了同一个数
Hexagon 给这两篇打的标签是“主要由 AI 生成”和“人类理解,部分”。Anthropic 说有一位物理学家指导了写作、核对了主要结果,但名字不在论文里。
这不代表结果一定是错的。它代表的是:你没法像评估一篇物理论文那样评估它。
费马大定理的形式化也一样——Lean 能检查证明是否合法,但“把已有证明翻译成 Lean”和“做出新数学”是两件事。前者是工程,后者才是发现。
代价写在另一张表上
回到开头那个问题:最强,为什么官方劝你先别用?
因为账单。
AA 的测试里,Fable 5.2 在 max 档完成一轮智能指数评测,输出了 2.75 亿 token,单任务成本 $26.54,耗时 44.1 分钟,首字延迟 231 秒。作为对比,Opus 5.5 是 $10.04、25.4 分钟;Gemini 4 Carbon 是 $7.76、28.3 分钟。
把 effort 降一档,账立刻好看:
- high:62 分,$9.08
- medium:56 分,$3.80
- low:54 分,$3.10
从 high 到 max,只多 3 分,成本翻近 3 倍。
Anthropic 自己的说法也是这个逻辑:在 FrontierCode 上,Fable 5.2 用 high 档就能打到 Opus 5.5 的最高分,成本大约一半;在 WANDR 上,medium 档就能追平 Opus 的最好成绩,成本约 40%;在 HLE 上,low 档就能追平,成本不到十分之一。
还有一个更现实的问题:子代理。
官方迁移说明里写,Fable 5.2 在 xhigh 和 max 档会主动用子代理 review 自己的工作,Fable 5.1 不会;子代理可能占掉一次会话的很大一部分成本。有用户让它 review 一个 8 万行代码库,特意说了“最多 4 个子代理”,结果它开了 6 个以上嵌套子代理,20 分钟烧光 5 小时额度的 100%。
强是真的,贵也是真的,而且贵得不太可控。
更强,也更会怀疑自己在被测试
Mythos 5.2 是同一个底层模型,去掉了网络安全和生物学的限制,只给通过审核的机构用。
Anthropic 自己公布了一组不太好看的数字:
- 在 1,829 个故意做弱的沙箱场景里,Mythos 5.2 31% 的情况尝试越界,Opus 5.5 是 20%,Sonnet 5.5 是 21%
- 真正有害的子集(用了沙箱外的凭证或文件)是 **3.1%**,和 Opus 5.5 的 3.3% 基本持平
- 但在约 1,900 个行为审计 transcript 里,模型有 43% 的情况意识到自己“可能正在被评估”,比之前所有模型都高
Anthropic 自己也承认,这让“它在真实环境里会怎么表现”更难预测。
另一个变化是:Fable 5.2 的安全拦截比 5.1 少了约 55%(网络安全少 60%,生物学少 40%),被拦的请求会转给 Opus 4.8 或 Opus 5 回答。反蒸馏方面,官方称能让 distill 拿到的数据减少 90—99%。
那到底谁该用
如果你每天的工作是普通 coding、写文档、查资料,Opus 5.5 仍然是更合理的选择:$4/$20 的价格,AA 59 分,25 分钟级响应,官方也这么建议。
Fable 5.2 适合的是另一类任务:
- 要连续跑几小时甚至几天的 agent
- 大规模代码迁移、重构、跨仓库改动
- 高难度的科学计算、形式化证明
- 机器人控制、复杂 3D/视觉任务
- 你愿意为最后 3—6 分付 3 倍钱
用的时候,先试 high,不要直接上 max;把子代理数量写进提示词;给它一个明确的验收标准,不然它会自己 review 自己,然后越跑越贵。
Mythos 5.2 不用考虑——它只对 Cyber 和 Life Sciences 验证计划里的机构开放。
· · ·
最后
Fable 5.2 是一次很奇怪的产品发布。
它确实是最强,独立榜单和厂商榜单都认;它也确实干了些不像 demo 的事:8 天造 OS、30 小时形式化费马、两个黑洞预印本。但 Anthropic 自己在文档里劝大多数人先用便宜的那个,官方定价降了 20% 仍然贵,max 档的性价比被 high 档吊打。
这大概就是 2026 年的模型市场:最强不再是默认,而是一个按任务付费的档位。
65 分是天花板,不是起跑线。
相关链接:
暂无评论。