烧掉 262 万美元的训练,小米把账本和秘方一起开源了
AI 圈的开源发布看多了,套路基本固定:放权重、贴跑分、附一张和 Claude 的对比表,完事。
9 月 22 日小米发布 MiMo-V2.6 系列的时候,多做了三件事:把 6 天强化学习训练的完整过程做成 Live 公开,把训练烧掉的钱摆上台面(Flash 约 85 万美元、Pro 约 262 万美元),再把 7000 多个 RL 训练任务环境和整套训练框架一起开源。
权重开源是给你鱼,这套操作是把渔场的布置图也交了出来。
46 分是个什么概念
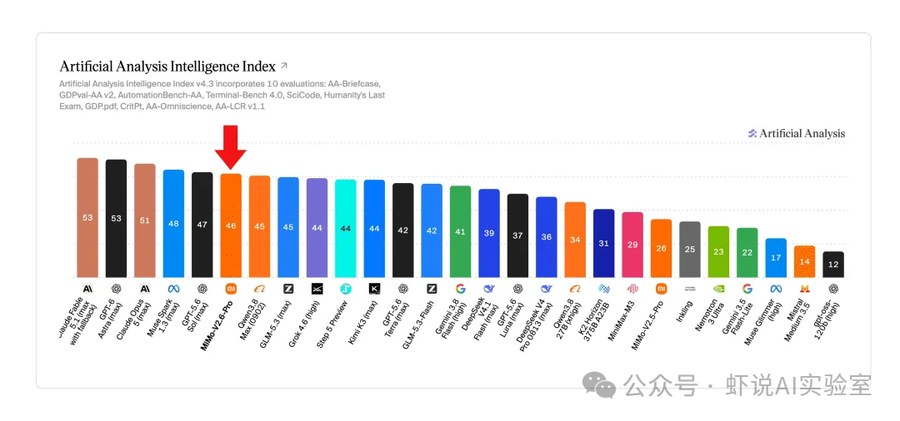
先说结果。MiMo-V2.6-Pro 在 Artificial Analysis 智能指数(AA Intelligence Index)拿到 46 分,超过 Qwen3.8 Max 和 GLM-5.3(均为 45 分),成为当前最强的开源模型。
有三点值得单独说:
第一,这个分数是 Artificial Analysis 自己跑的,不是小米自测。AA 用自己的评测框架跑了十项测试——推理、知识、数学、代码,包括 Terminal-Bench 4.0、Humanity's Last Exam 这些硬茬。第三方独立评测给出的 46 分,比厂商自报的分数可信得多。
第二,和闭源的差距官方自己承认了。官方公告原话:与最强的闭源模型 Claude Fable 5.1 和 GPT-6 Astra 相比,仍有差距。榜单上 Fable 5.1(max)在 53 分以上,差着七八分。开源追闭源还剩最后一小段,但“最强开源”这个位置,暂时姓米。
第三,性价比这一侧更夸张。AA 实测 MiMo-V2.6-Pro 每个评测任务成本 0.13 美元,正好落在“智能-成本”帕累托前沿上。对照榜单:Kimi K3(max)每任务约 1.8 美元,GLM-5.3(max)约 2 美元,Claude Opus 5(max)约 4.5 美元——同样跑一遍评测,成本差着 14 到 35 倍。
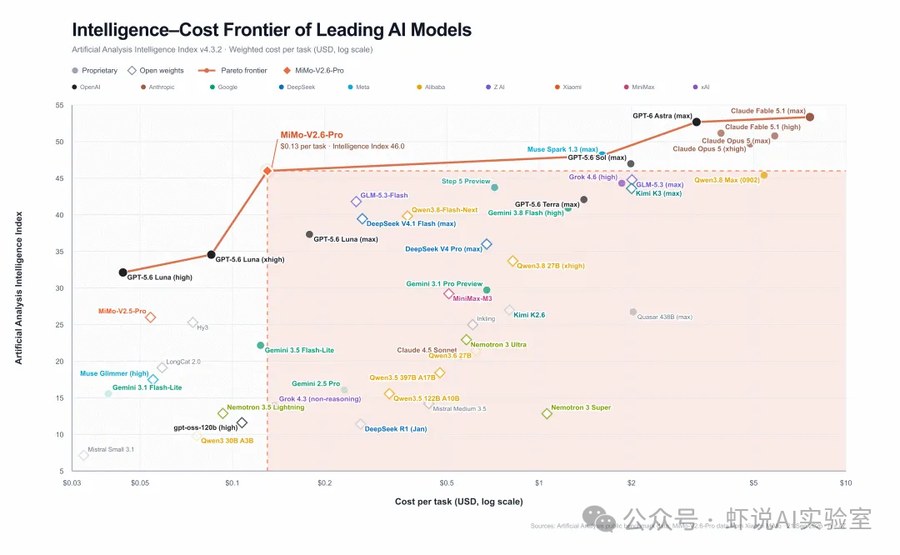
官方口径是“同等智能水平下,价格仅为海外模型的 1/20 至 1/60”——比的是达到同样智能所需的花费,与榜单直接对比口径不同,但结论一致:这是目前性价比最狠的一档模型。
顺手说下价格:V2.6 沿用 V2.5 定价,Pro 在 256K 上下文内输入 1 美元、输出 3 美元每百万 token(1M 上下文 2/6 美元),MIT 协议。权重、技术报告、训练资源全部放开。
| 模型 | AA 智能指数 | 每任务成本(AA 实测) | 权重 |
|---|---|---|---|
| Claude Fable 5.1(max) | 53+ | 约 4.0 美元 | 闭源 |
| Claude Opus 5(max) | 53 | 约 4.5 美元 | 闭源 |
| GPT-5.6 Sol(max) | 约 47 | 约 1.0 美元 | 闭源 |
| MiMo-V2.6-Pro | 46 | 0.13 美元 | MIT 开源 |
| Qwen3.8 Max | 45 | 约 2.0 美元 | 闭源 |
| GLM-5.3(max) | 45 | 约 2.0 美元 | 开源 |
| Kimi K3(max) | 42 | 约 1.8 美元 | 开源 |
6 天 30 步,烧钱账本长什么样
这次发布真正的干货,是把 RL 训练这件事的“黑箱”拆开了。
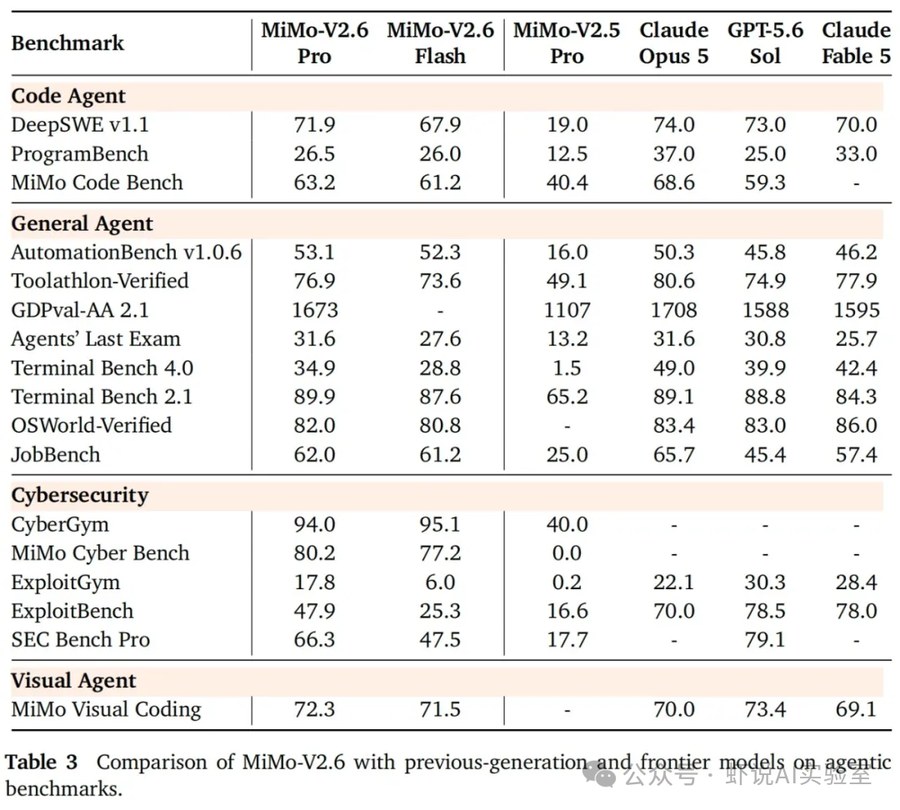
6 天 Live RL,Flash 和 Pro 各跑了 30 步,累计约 75 万条轨迹,成本分别约 85 万和 262 万美元。训练任务的通过率 Flash 提升 25%、Pro 提升 12%。
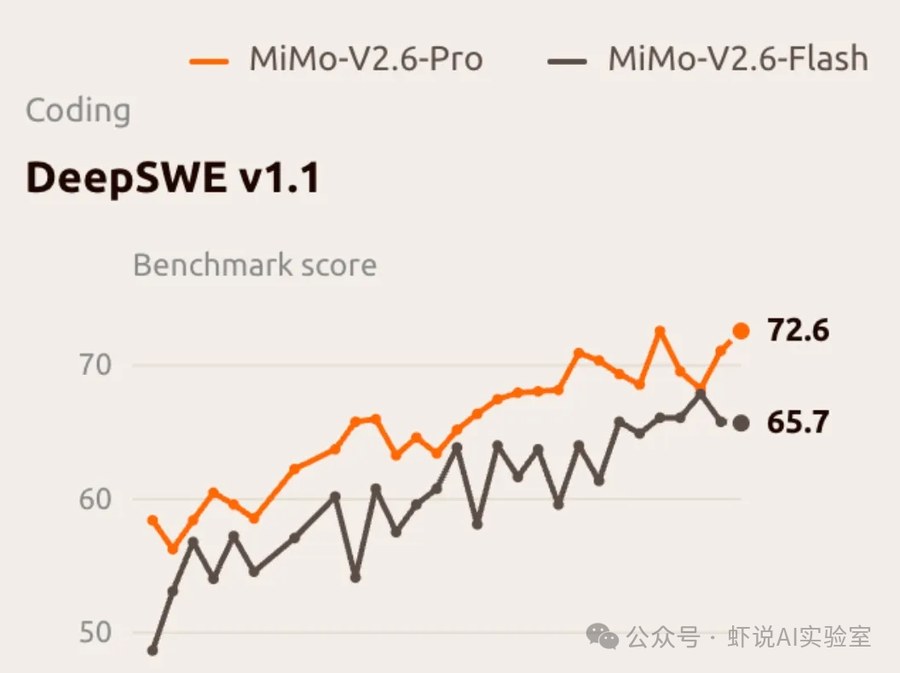
但真正值钱的是样本外数据:长程软件工程基准 DeepSWE v1.1 上,Flash 从 48.8 涨到 65.7(+17 分),Pro 从 58.4 涨到 72.6(+14 分)。训练集里没见过的任务还能涨这么多,说明 RL 学到的是能力,不是背题。
算力从三个维度往上堆:单次更新 1568 个样本、支持 1M 上下文训练、单步 3.5-3.7B token;任务覆盖 Code、General、Visual、Cyber 四个方向;Grader(评分器)算力同步加大,引导模型用更短路径、更少 token 完成任务。工程上,冻结 MoE Router 抑制专家负载漂移,再建一道覆盖奖励设计、对抗评测、异常检测的 Reward Hacking 防线——防的就是模型“学会骗奖励”。
从写代码到造世界
能力侧的变化用一个词概括:编程的边界从代码延伸到了世界。
- 3D 开放世界游戏:输入图片、视频或文字,多智能体协作完成场景搭建、交互逻辑编写和视觉验证,产出可运行的交互世界
- Blender 建模:文字或图片直接生成可用于动画、3D 打印的资产
- 具身智能:多视角相机画面输入,视觉反馈闭环控制 Franka Panda 机械臂,完成抓取、颜色匹配与精准放置
- Computer Use:理解复杂图形界面,操作办公工具,根据视觉反馈排查问题、调整行动
科研侧也有两个硬案例:没做过专项训练,Pro 在 Lean 4 里完成了 Li–Yorke《周期三蕴含混沌》主定理的完整形式化,6000 余行源码通过 Lean 内核核验;材料方向协助设计吸附 PFAS 的 MOF 材料,自动搭模拟环境计算结合强度。设计榜单 Design Arena 上与 Claude Opus 5、GPT-5.6 Sol 相当。
冷静一点说
跑分归跑分,有三件事得掰开看。
训练门槛没有因为开源而消失。85 万和 262 万美元只是 6 天 RL 的成本,前置的预训练和半年的基础研究还没算。开源的 7000 个任务环境和 verl、uni-agent、mini-swe-agent 框架是真能用的,但“秘方给了”不等于“你家灶台烧得起”——完整复现这套训练,预算门槛在百万美元级。9B 的 Distill 模型倒是给个人开发者留了一条缝:从 SFT 基线做 RL,SWE-bench Verified 从 61.1 提到 66.2,11 项评测全部提升。
跨版本比分要小心口径。有解读把上一代 MiMo-V2.5-Pro 的 26 分和这次的 46 分相减,得出“暴涨 20 分”。但 26 分是旧版指数记的,46 分出自 v4.3.2 新口径——版本换了,分母变了,直接相减没有意义。真实情况是这代确实大幅提升,幅度要等同口径数据出来再下结论。
榜单分数不等于你的体验。46 分是十项评测的复合值,具体到你的场景——长文本、代码、视觉、中文创作——表现分布并不均匀。官方说 Flash 这代“全面超越 V2.5-Pro”,但 Flash 的详细规格还没铺开,跑批任务建议先小流量试。
开源清单与使用路径
这次放出的东西:Pro 与 Flash 权重加技术报告、Distill-Qwen-9B、7000 多个 RL 任务环境(覆盖软件工程、漏洞复现、知识工作、网页设计四类)、端到端 RL 训练框架、可组合的 mini-harness。
三条使用路径:
- 普通用户:MiMo Desktop 桌面客户端,订阅即用,Pro 支持 20 倍速 UltraSpeed 模式
- 开发者:API 开放平台,模型名 mimo-v2.6-pro、mimo-v2.6-flash、mimo-v2.6-pro-ultraspeed
- 研究者:HuggingFace 拉权重,任务环境和训练框架都在,可直接复现 RL 训练
最后说两句
小米在公告里引了句古文:“夫夷以近,则游者众;险以远,则至者少。”平路好走所以人多,险路难走所以人少——他们选择把算力投进真实环境的试错里。
这轮开源之后,开源竞争的题目变了:上半场比谁开源权重,下半场比谁开源配方。王座会换人,但“把训练过程晒在阳光下”这件事一旦开始,就回不去了。
相关链接:
- 官方公告:https://mimo.mi.com/docs/zh-CN/news/latest/v2-6
- HuggingFace 开源集合:https://huggingface.co/collections/XiaomiMiMo/mimo-v26
- MiMo Desktop:https://mimo.xiaomimimo.com/desktop/
- Artificial Analysis 模型页:https://artificialanalysis.ai/models/mimo-v2-6-pro
暂无评论。