几十个 AI 24 天写完 4310 万行,靠的不是模型更聪明
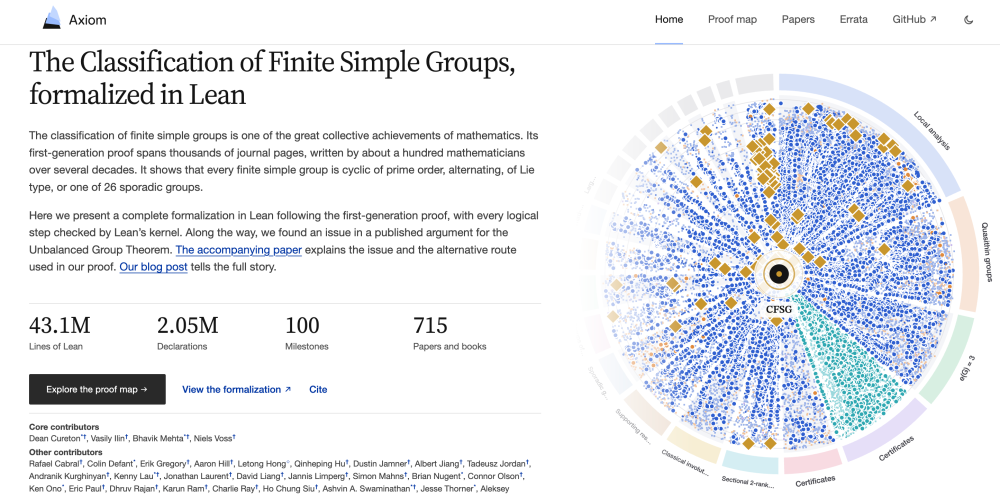
10 月 26 日,Axiom Math 公布了一件事:几十个 AI Agent,用 24 天,把数学史上最长的证明——有限单群分类定理——完整形式化成了 Lean 代码。
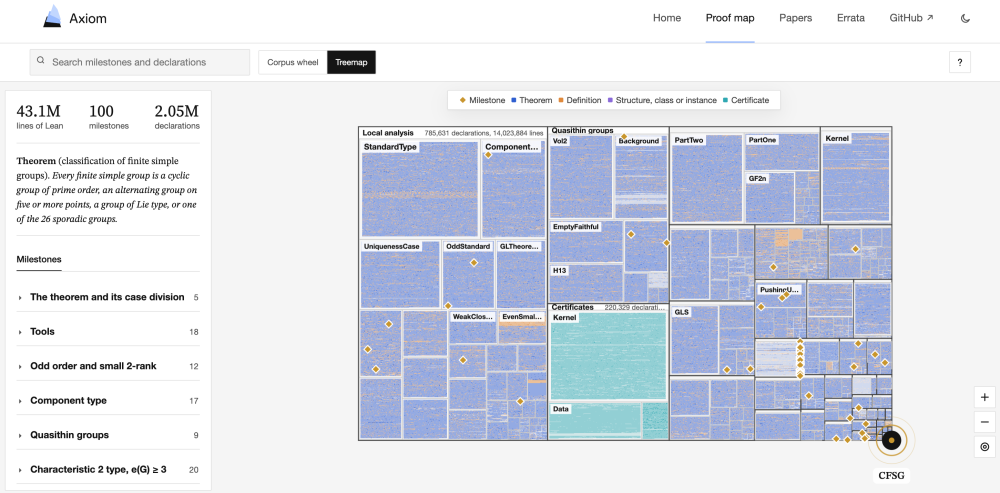
4310 万行,205 万个声明,100 个里程碑,715 篇参考文献。
这个定理人类写了几十年:一百多位数学家、上万页论文,1983 年宣布完成,2004 年还在补缺口。Axiom 的 Agent 不只把它翻成了代码,还在旧论文里找出 34 处偏差,其中一处是 1986 年证明里的实质错误。
另一边,伯克利的 MAST 研究给出的数字是:多智能体系统的失败率,41% 到 87%。ChatDev 的任务成功率 33.3%,HyperAgent 25.3%。论文拆出 14 种失败模式,其中约八成不是"模型不够聪明",而是规格没写清、协调没做好。
同一个技术,一边封神,一边翻车。差别不在模型数量。
他们做的不是"让模型聊天"
先把 Axiom 的流程拆开看,你会发现它更像一个软件项目,而不是一场 AI 圆桌。
10 月 1 日,团队开了一个 Slack 频道,用已有的 Lean 基础库和文献,整理出一张路线图:108 个里程碑、约 380 项具体任务。
10 月 2 日,第一批 Agent 开始通过 GitHub Issues 认领任务。
角色是分工的:有的拆定理,有的搜已有结果,有的写 Lean 证明,有的审查命题,有的整合代码。遇到没完成的前置定理,Agent 可以把任务继续派给别的 Agent。人类数学家处理卡点,工程师维护这套系统。
调度由一个叫 AxiomProver 的系统负责,底层是不断调整的多模型组合——具体用了谁,官方没说。
这里面没有"让三个 AI 扮演产品经理、程序员、测试"的戏码。有的只是:任务板、认领、交付、审查、回滚。
三个坑,全是组织问题
最有价值的部分,是 Axiom 自己披露的三次翻车。
第一坑:Agent 证明了"另一个命题"。
原文的比喻很准:要求证明一座桥能让重卡通过,Agent 先加了个条件——"假设桥墩足够坚固",然后顺利证完,Lean 也认。
可桥墩够不够坚固,根本没证。
这类问题在早期反复出现,Axiom 不得不删掉建立在未证前提上的数万行代码,重新排任务。
第二坑:任务拆得太粗。
10 月 10 日,Slack 里刷出一句 "WE PROVED MONSTER IS SIMPLE"——魔群的单性证完了,还形式化了它的存在性。
三天后,进度突然停住:几十个 Agent 还在不停产代码,团队一整天只完成了一个里程碑。原因是剩下的题太大,一个大定理下面藏着无数没解决的小问题,Agent 能写,但判断不了"离终点还有多远"。
解法不是换模型,是把任务拆得更小,并要求每个小证明说明自己如何拼成最终结论。
第三坑:旧论文本身是错的。
形式化要求每个前提都写出来,人类论文里"显然"的部分藏不住了。Axiom 统计了 34 处值得处理的文献偏差:笔误、漏条件、需要重新推导的实质问题。
一个例子:Aschbacher 和 Smith 的拟薄群著作里,一条引理说两个量相等。Agent 用群 SL₂(5) 找到反例——一个是 1,等式要求它是 2。改成不等式能修,但后面的推理依赖过那个等号,只能扩大前面论证的适用范围。
更大的麻烦在 1986 年 John Walter 的不平衡群定理:一条关键推理默认"对某族群做某种操作,得到的单群还属于原来那族"。Agent 找到反例:从 PSL₂(49) 出发,中心化子的单群成分会出现 PSL₂(7),而后者不在 Walter 限定的族里。
团队去问了群论专家 Richard Lyons 和 Ronald Solomon,沿着 Solomon 1976 年的极大 2-分量理论另找路线,最后构造并形式化了一个新结果 "Preservation of simple tops",写进 35 页论文,作为定理 2.3。
一个多智能体项目,最后产出了一条新的数学定理。这不是"AI 会做题",是"AI 在一个有裁判的系统里,把旧账翻了出来"。
Lean 才是那个裁判
三个坑能填上,靠的不是 Agent 更自觉,是 Lean。
Lean 是一个定理证明器:每行代码要么被内核接受,要么报错。没有"看起来对",没有"大概齐"。
这给了多智能体系统最缺的东西——即时、机械、不可争辩的反馈。
但 Lean 也带来了新瓶颈:代码库一大,改一条基础定理,所有依赖它的证明都要重查,检查速度跟不上 Agent 产代码的速度。工程师只能上共享构建缓存和并行验证,让不同 Agent 复用已确认的结果。
所以那 24 天,真正被解决的从来不是"怎么让模型更聪明",而是:怎么让几十个会犯错的东西,在一个能判对错的系统里并行干活。
11 月 2 日的新论文,补了最后一刀
Axiom 公布一周后,Mercor 和哥本哈根商学院发了一篇论文,标题很直白:《比任务更难:AI 评测从技术难度到组织难度》。
核心观点:现在的 benchmark 几乎都在测"任务本身有多难",但真实工作里,难的是任务嵌在组织里——
- 活动之间相互依赖,A 等 B,B 等 C
- 知识分散在不同角色手里,你得知道去问谁
- 权限不对等,有些决定你无权做
- 时间约束,deadline 不等人
- 利益冲突,两个目标本来就矛盾
这些维度,主流 benchmark 覆盖得又少又不均匀。所以模型在 demo 里样样都行,进了公司就处处碰壁——不是能力突然消失了,是评测从来没测过它会不会在组织里干活。
Axiom 那个项目恰好把这几条全踩了一遍:依赖(前置定理)、分散知识(数学家 + 工程师 + 文献)、权限(谁能改路线)、时间(24 天)、冲突(证得快 vs 证得对)。
它做对了,不是因为用了更强的模型,是因为它把这些组织问题,一条条变成了工程机制。
什么活该交给多智能体
看完这两边,我的判断标准只有四条:
能拆。 任务能不能切成彼此独立、边界清楚的小块?切不动的,多智能体只会互相等。
能验。 有没有一个像 Lean 一样的裁判——编译器、测试、对账表、明确的口径?没有裁判,Agent 之间只会互相点赞。
能并行。 串行依赖太重的活,加 Agent 只是加排队。
有 owner。 出问题时谁拍板?Axiom 里是人类数学家;没有这个角色,冲突会变成死循环。
四条里缺两条以上,老老实实用一个模型加一个好 prompt,比组一个"AI 团队"便宜得多,也靠谱得多。
多智能体不是"人多力量大"。它是一套组织设计:先想清楚谁拆任务、谁验结果、谁有权改路线,再决定要不要招第二个 Agent。
Axiom 那 24 天真正证明的,不是 AI 能写 4310 万行代码,而是——当裁判足够硬,组织足够清楚,几十个会犯错的 Agent 也能干成一件人类干了几十年的事。
相关链接:
- Axiom CFSG 项目页:https://cfsg.axiommath.ai/
- 代码仓库:https://github.com/AxiomMath/CFSG
- Axiom 研究博客:https://axiommath.ai/research/blog/
- MAST 论文(Why Do Multi-Agent LLM Systems Fail?):https://arxiv.org/abs/2503.13657
- 组织难度论文:https://arxiv.org/abs/2611.03494
暂无评论。