你的显卡,有一半是锁着的
一张 RTX 3090 Ti,在 450W 下,BF16 从 87.5 TFLOPS 跑到 157.4。
没超频,没换散热,没刷 VBIOS。只在一个 Linux 内核模块里,改了两个 bit。
这个模块叫 gpu-unlock。10 月 18 日建库,到 11 月 15 日,19,822 星、2,058 fork、137 个 open issue。
它干的事只有一件:把 NVIDIA 在 GeForce 上关掉的那一半张量算力,重新打开。
刀切在哪儿
NVIDIA 自己的白皮书里,数字摆得很清楚。
RTX 3090 的 FP16 算力有两行:16 位累加是 142 TFLOPS,32 位累加是 71,正好一半。BF16 只列了 32 位累加,也是 71。
同一颗 GA102 芯片,做成 RTX A6000,三行都是 154.8,没有“半速”那一行。
散热和功耗墙都不是原因。原因在产品档位:消费卡保留 16 位累加的全速,但 AI 训练和非量化推理几乎都用 32 位累加——那一条被锁在一半。
gpu-unlock 解锁的就是这一条:FP16 / BF16 / TF32 配 FP32 累加的指令发射速率。
它不改驱动,改的是启动顺序
大多数“解锁”要刷 VBIOS,或者给 NVIDIA 驱动打补丁。驱动一升级,补丁失效,重来一遍。
gpu-unlock 换了个时间点:它把自己塞进 initramfs,在 NVIDIA 驱动绑定显卡之前运行。
启动时它做三件事:
- 写入速度选择器:SS0
0x88888888(全速 BF16),SS10x8(IMLA4) - 对显卡做一次 FLR(Function Level Reset)
- 退出,让未修改的 NVIDIA 驱动正常接管
所以驱动更新不用重做,因为驱动根本没被改过。休眠唤醒后它还会再解一次,代价是唤醒多花大约一秒。
项目说明里写得很直白:这不是 UEFI 应用,也不是改过的 NVIDIA 驱动。它只是在驱动之前,把两个选择器拨回去。
纯算力翻倍,聊天几乎不变
先看纯矩阵乘法。项目 README 给的数字(单位 TFLOPS,8192×8192×8192,FP32 累加,默认功耗):
| 显卡 | 解锁前 | 解锁后 | 提升 |
|---|---|---|---|
| RTX 3060 12G | 27 | 51 | +87% |
| RTX 3090 | 75 | 125 | +65% |
| RTX 4090 | 165 | 329 | +100%(峰值) |
4090 那一行是峰值 MMA 速率。它跑大 GEMM 会先撞功耗墙,实际增益远小于 100%。
看起来是白捡一倍。但把同样的卡放进真实负载,数字立刻分层:
| 负载 | 典型提升 |
|---|---|
| vLLM prefill(3090,250–375W) | +25–50% |
| 4×3090 prefill(社区实测) | +10–12% |
| llama.cpp / Ollama 4-bit GGUF | 0–15% |
| 逐 token 解码 | 0% |
| INT8 / FP8 / INT4 | 0% |
| 游戏、FP32 CUDA | 0% |
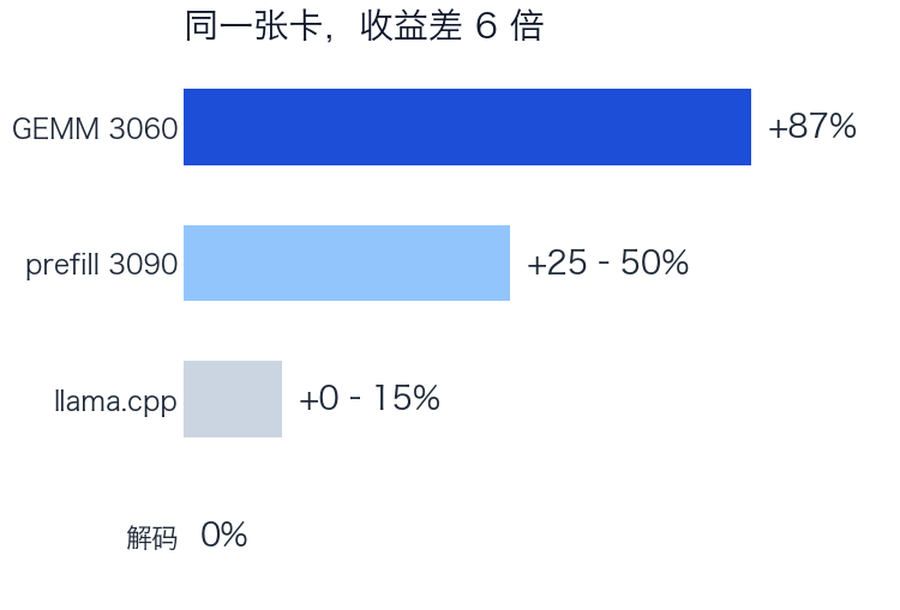
原因不复杂:prefill 是计算密集,矩阵乘法多,能吃到张量核;decode 是显存带宽瓶颈,算得再快也得等数据搬过来。
所以“解锁后聊天快一倍”是假的。真正快的是长提示词的首 token、批量推理、微调、图像生成这些计算密集的环节。
真跑起来的人,测到了什么
项目 issue 里有几份比较完整的实测。
一位 3090 用户用 vLLM 跑 Qwen3.8-27B W4A16,固定 250W 到 375W 五档:
- 250W:prefill 1089 → 1362 tok/s,+25%
- 375W:prefill 1296 → 1939 tok/s,+50%
- 每 token 能耗下降 20–35%
- decode 基本不动,有的档位还低 1–3%
另一位在 141k 长上下文上测 Qwen3.8-27B:prefill +43%,decode 在深上下文下 +11%,短提示 decode +1%。
还有人拿 4 张 3090 跑 Qwen3.8-Flash-Next:prefill 只涨了 10–12%,但输出和原来逐字节相同。他原本预期 14–19%,自己在帖子里承认估高了:GEMM 阶段确实短了 23%,但 GEMM 只占 prefill 的 40%,INT8 专家、数据拷贝、CUDA core 那些都没变快。
这些数字比 README 的“最高 2 倍”更值得看:同一张卡,跑 GEMM 能翻倍,跑聊天几乎不动,跑 MoE 推理只涨一成。
代价在 issue 里
137 个 open issue,不是摆设。
翻一遍标题,能看到各种“解锁失败”“黑屏”“卡死”:
- RTX 3080 20G:S3 唤醒后显卡从总线掉下去(Xid 79),大约 25 次唤醒遇到 1 次
- Proxmox 直通:加载模型时把宿主机整个冻住
- Fedora 44 + Secure Boot:启动黑屏
- 5 张 3090 接在 PEX880xx 交换机后面:整组交换机丢失,Xid 79
- 还有一堆 2070 Super、2080 Ti、3060 移动版“解锁完成但速度没变”
问题在于它动的是启动链最底层:内核模块、initramfs、root 权限、显卡固件。失败的表现不是“软件报错”,是开不了机、黑屏、显卡掉总线。
还有几个硬约束:
- Linux only。Windows 只有第三方移植,项目作者自己说“不打算维护”
- RTX 50 系不支持,20/40 系标的是 Experimental,30 系才是 Stable
- 笔记本的独显一旦断电就会重置,解锁静默失效
- Secure Boot 开着就得自己签名模块,或者关掉
- 项目 10 月 28 日之后没有新提交,主维护者只有一个人(9 次提交,另有一个叫
claude的账号 4 次)
README 里专门写了一句:没有官网、没有代币、没有安装器,任何网站、加密货币、安装器都和这个项目无关。
这句话不是客套。一个要 root、要进 initramfs、要改显卡固件的工具,最容易被拿去做成“一键安装包”。
什么人适合试
适合:
- 有一台 Linux 工作站,显卡是 3090 / 3090 Ti / 4090
- 主要跑 vLLM、ComfyUI、微调,吃 prefill 和矩阵乘法
- 能接受重装系统、能进 recovery、不是生产单机
- 愿意自己从源码编译,不用任何预编译包
不适合:
- Windows 用户
- 笔记本用户
- 靠这张卡吃饭的生产环境
- 只跑 llama.cpp / Ollama 聊天,decode 为主
- Secure Boot 必须常开、不能签自定义模块
- 看到“2 万星”就想一键安装的人
硬件没变,变的是许可
同一颗 GA102,NVIDIA 卖两种档位:消费卡锁一半,专业卡放开,价格差几倍。
gpu-unlock 证明的是:这道锁在固件里,不在硅片里。
算力放出来了,风险没有因此减少。你的卡不会因为快 65% 就变得更安全,驱动也不会因为绕过一次检查就获得官方支持。项目作者自己在 FAQ 里写“very unlikely”会伤卡——这是他的判断,不是 NVIDIA 的保证。
想试的人,先去 issue 里搜自己的显卡型号,看看有没有人成功、有没有人黑屏。看完再决定要不要把 root 交出去。
参考来源:
暂无评论。